


 |
 |
 |

CPU種類:Apple M5 Maxチップ メモリ容量:36GB ストレージ容量:SSD:512GB 発売時期:Late 2026

※OSは出荷時期によって、変更されている場合があります。ご購入の際は購入店舗にて直接ご確認ください。
本ページでは掲載するECサイトやメーカー等から購入実績などに基づいて手数料を受領しています。
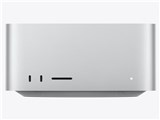
Mac Studio MHL64J/A [シルバー]Apple
最安価格(税込):¥398,000
(前週比:±0  )
発売日:2026年 9月22日
Mac Studio MHL64J/A [シルバー] のクチコミ掲示板
(10件)

このページのスレッド一覧(全5スレッド)

| 内容・タイトル | ナイスクチコミ数 | 返信数 | 最終投稿日時 |
|---|---|---|---|
 WindowsのOpenCode系へUIへの接続 |
0 | 0 | 2026年10月21日 18:17 |
 ローカルLLMはかなりGPU依存度高い? |
0 | 0 | 2026年10月10日 15:14 |
| 128GB CTO版でGLM-5.3-FlashのAJ-IQ3_XXS版を試行 |
1 | 3 | 2026年10月8日 01:56 |
| M5とM4のMLX分散実行も問題なし |
0 | 0 | 2026年9月26日 20:57 |
| 9/22→9/25 |
1 | 2 | 2026年9月26日 02:48 |
最初|前の6件|次の6件|最後




- 「質問の絞込み」の未返信、未解決は最新1年、解決済みは全期間のクチコミを表示しています


 お気に入りに追加


Mac デスクトップ > Apple > Mac Studio MHL64J/A [シルバー]


 |
|---|
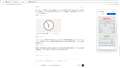
xclockっぽいアプリを作ってもらった |
Genspark Super Apps がOpenCode系だったので、Windowsのクライアント機からMac StudioのLLMサーバに接続させてみました。
GLM 5.3 Flashしか試してないですが、素のOpenCodeだとDS4とのやりとりに壊れたデータを渡すことがあり、無反応にみえる現象がおこるので、GenCodeでもProxyをかませて成形しなおしています。
Windows側でVisual StudioでC#の空プロジェクトをつくり、Genspark Codeのプロジェクトに設定し、GUIプログラムの作成指示を出しています。思考なしだと何度か止まったものの、Reasonerにするとプログラムの作成から動作検証まで一通り完成させてくれました。
これで、出先のモバイルでもデカモデルを心おきなく使うことができるようになりました。
 0点



Mac デスクトップ > Apple > Mac Studio MHL64J/A [シルバー]
|
|---|
|


AIがマシン壊しにきてもいいよう、モデル動作環境をVMに持っていきました。
MacではParallels上のVMを使い、WindowsではWSLにOpenCodeの組み合わせで環境を分離していこうと思います。
負荷を調べていて、モデルやランタイムにもよるけど思ったよりCPU使われないことに気がつきました。
LM Studio+LagunaS2.1はバランス型だけど、DowarfStar4+GLM5.3 FlashはほぼGPUしか動かず(MLXばっかり使ってるのもあるんだろうけど)。
LLMサーバー上でVMかませてもそこそこ速度が出るので、1台で事足りてしまいそうです。
0点
Mac デスクトップ > Apple > Mac Studio MHL64J/A [シルバー]

モノが届いたので、早速試してみました。
GLM-5.3-FlashのAJ-IQ3_XXS版を、128 GiBメモリのMac Studioで検証。
モデルは合計112.4 GBのGGUF 3ファイル。
ランタイムにはMetal対応の llama.cpp を使用し、コミット 1d0c76f3c、llama-server 0.3.0-dev(build 10791)に固定しました。
起動条件は -ngl 99 -ncmoe 20 -fa on -c 8192 -np 1 -b 512 -ub 128 -ctk q8_0 -ctv q8_0 --jinja。サーバーは 127.0.0.1:8080 で待ち受け、単一スロット・単一リクエストずつ試験しました。
算術、ログからの値の抽出、本文にない情報を推測しない応答、会話履歴の参照、120・300・500・650行のデータからの位置別検索を実施。テストした全てのケースで期待した回答が得られました。長文検索の実測値は次のとおりです。
入力データ入力tokens入力処理速度生成速度応答時間結果
120行1,32829.04 tokens/秒14.77 tokens/秒約52秒正答
300行3,30735.64 tokens/秒13.86 tokens/秒約100秒正答・切り詰めなし
500行5,50732.90 tokens/秒13.06 tokens/秒約176秒正答・切り詰めなし
650行7,15746.62 tokens/秒12.26 tokens/秒約162秒正答・切り詰めなし
メモリ圧迫は試験中に緑と黄色を往復。スワップ使用量の観測値は、650行試験の前後で 71.31M → 113.81M でした。
この構成では、少なくとも7,157入力tokensの単発リクエストで正しい応答を生成できました。
ただしこれは各条件1回ずつの合成データ試験です。
1点

GLM-5.3-Flash-Q4_K.ggufというモデルファイルは、190GBのデカいサイズで通常ならメモリに入りません。
しかし、必要になった時だけSSDから重みをロードしてくれる推論エンジンがあるので、この機能を使ったらどのくらいの速度で推論できるか確かめました。
実行したワークロードは、Macを推論サーバにtailnetを介して接続し、WindowsのWSL上のUbuntuで動作するOpenCodeでGUIプログラムを作らせてみました。作らせたのは、xclockと同一の機能を持つ時計アプリです。
環境に不足していたパッケージなどを追加インストールし、自己テストOKまで到達し、実際に動作するアプリが出力されました。所要時間は、コーディングやテスト自体は6分程度で完了、その他含め9分。
・ds4が計画したメモリ使用量:89.36 GiB(128 GiB搭載)
・回答生成:短い対話で約7~10 tok/s、長いツール作業でおおむね7~8 tok/s
・7,136トークンの入力処理:84.4秒、平均84.54 tok/s
(ツール作業中の小さな追加入力:8~53トークンでも、各回の入力処理に約0.5~5秒。特に長い生成では、1,114トークンを145.6秒、平均7.65 tok/sでした。
自分の忍耐限界が15 tok/sなので、「Opus4.6-4.8程度に頑張るけど、常用には遅い」という結論です。
GLM-5.3-Flash-Q2だともっと早いけど、手軽にLM StudioでロードできるLaguna S2.1があるし、手間をかけてロードするのもうーん・・・
書込番号:26563601
0点
Q2をSSD-Streamingなしで起動すると、
起動時のメモリ計画 93.21 GiB
長いツール作業中の生成 約29.4~29.6 tok/s
7,136トークンの入力処理 15.933秒、平均447.87 tok/s
でした。
こちらも完成まで持っていけて、動作もOKでした。
これくらいの速度なら、普通に使える。
[起動=ロード] /Users/user/work/ds4/ds4/ds4-server --chdir /Users/user/work/ds4/ds4 --host xx.xx.xx.xx --port xxx -m /Volumes/model/ds4/gguf/GLM-5.3-Flash-Q2.gguf --ctx 32768
ds4: Metal device Apple M5 Max, 128.00 GiB RAM
ds4: Metal 4 tensor API enabled for Tensor kernels
ds4: drift-patch flags hc_stable=on norm_unify=on kv_raw_f32=off rope_exp2_log2=off math_safe=off tensor_matmul=on
ds4: Metal model views created in 2.660 ms, residency requested in 706.841 ms, warmup 3.238 ms (mapped 92026.06 MiB from offset 9.07 MiB)
ds4: Metal mapped mmaped model as 2 overlapping shared buffers
ds4: metal backend initialized for graph diagnostics
ds4: memory: KV 0.37 GiB (raw 0.00 + compressed 0.37) + buffers 2.98 GiB + resident model 89.87 GiB = 93.21 GiB planned
ds4: memory detail: ctx=32768 prefill_cap=2048 raw_kv_rows=0 compressed_kv_rows=32768 backend=metal
1007 22:23:25 ds4-server: context buffers 3422.43 MiB (ctx=32768, backend=metal, prefill_chunk=2048, raw_kv_rows=0, compressed_kv_rows=32768)
ds4: GLM session ctx=32768 (model max=1048576); prefill/work cap=4096; dense attention limit=2051
ds4: GLM graph using compact DSA KV only; expanded full-attention KV cache is skipped
ds4: GLM graph allocating compact DSA cache: rows=32768 logical_ctx=32768 kv_layers=45 indexer_layers=11 f16 0.37 GiB
ds4: GLM compact indexed prefill chunk=2048 score_rows=2048 score_scratch=64.00 MiB
書込番号:26564898
0点
|
|---|
|
 |
|---|
ロード設定 |
オンデバイスでの応答速度。
ds4→LM Studioへプラグイン経由。
書込番号:26564909
0点
Mac デスクトップ > Apple > Mac Studio MHL64J/A [シルバー]
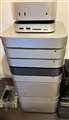
Mac Studio M5(128GB) + Mac Studio M4 (36GB) をTB5で接続し、MLXで分散実行できるかを確認してみた。
mlx.distributed_config` が生成したJACCLホストファイル(対称性確認済み)を用いて、`all_sum` を両rankで実行:
```json
{ "backend": "jaccl", "envs": ["MLX_METAL_FAST_SYNCH=1"],
"hosts": [
{ "ssh": "Mac-Studio-M5.local", "ips": ["192.168.10.106"], "rdma": [null, "rdma_en4"] },
{ "ssh": "Mac-Studio-M4.local", "ips": ["192.168.10.107"], "rdma": ["rdma_en5", null] } ] }
```
rank=0 size=2 sum=array([2, 2, 2, ..., 2, 2, 2], dtype=float32)
rank=1 size=2 sum=array([2, 2, 2, ..., 2, 2, 2], dtype=float32)
all_sum(ones(10))が2ノードで2を返したので、JACCL over RDMA の初期化と集団通信が成立したと判断。
Llama-3.2-3B-Instruct-4bitで分散推論もOK
mlx.launch --hostfile ~/cluster-jaccl.json -- mlx_lm.chat --model mlx-community/Llama-3.2-3B-Instruct-4bit --max-tokens 128 でチャットREPLを起動し、日本語プロンプトに対する応答トークン生成を確認:
>> 簡単に自己紹介して
私は、AIのコンポーネントです。... 私の知識は、2023年12月までに更新されました。
他、自作ベンチでちょびっとトークン生成させての簡易測定では、
M4 単ノード : 236.0 tok/s
M5 単ノード : 344.1 tok/s
TP×2 : 178.2 tok/s.
こんな感じ。
とりまこれでクラスタでも動かせることが確認できて一安心。
0点
最初|前の6件|次の6件|最後
この製品の最安価格を見る
 <22
のユーザーが価格変動や値下がり通知、クチコミ・レビュー通知、購入メモ等を利用中です

クチコミ掲示板検索
最適な製品選びをサポート!
[Mac デスクトップ]
価格.comマガジン
注目トピックス

(パソコン)
Mac デスクトップ
(最近3年以内の発売・登録)






